全球化通常指通过商品、服务、资本、技术及人员的跨境流动,导致全球经济、社会和文化日益一体化的过程。全球化的起源最早可追溯至15世纪末的大航海时代。二战后,全球化进入制度化阶段。至今,几乎所有国家都卷入了经济全球化浪潮。
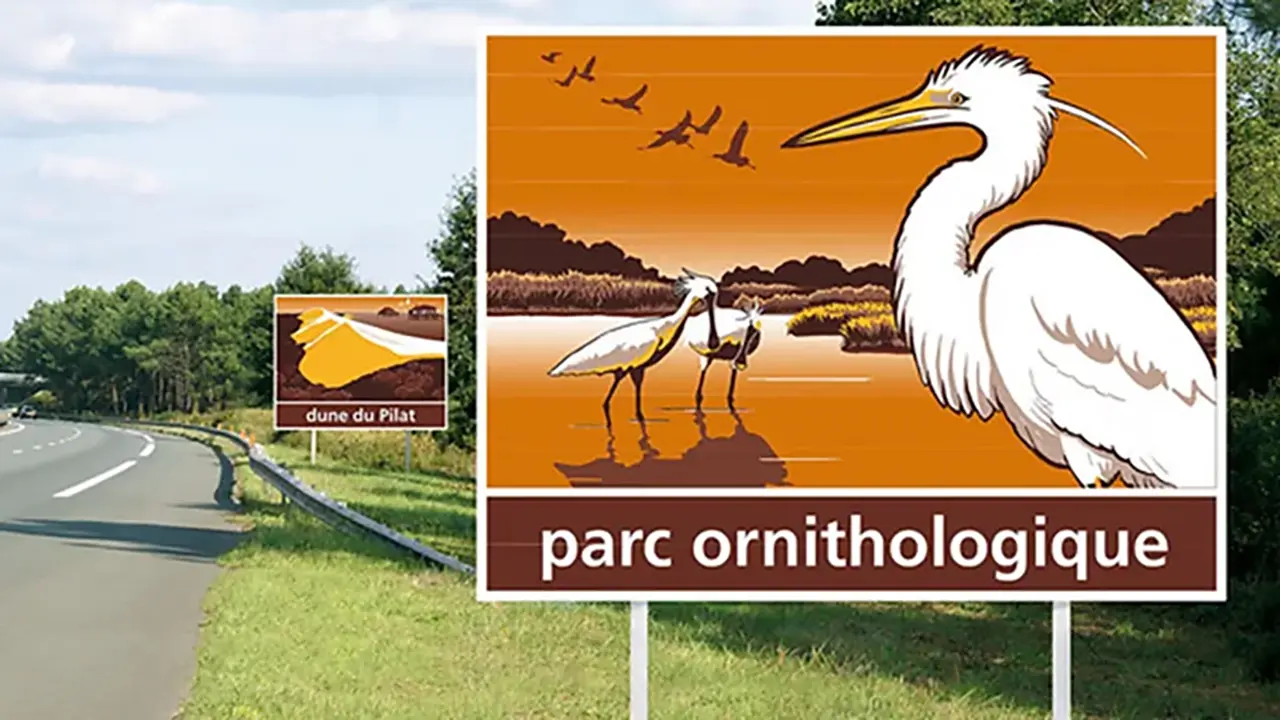
法国有成千上万个棕色高速公路标志牌,指引着高速公路上的司机前往纪念碑、葡萄园、当地名菜和景点,而不是巴黎妖艳的游乐园和购物中心。Credit: Philippe Collier
逆全球化并不是指世界完全退回到封闭孤立的状态,而是指全球化进程中出现停滞、倒退或碎片化的现象。2008年国际金融危机爆发后,逆全球化初现端倪,近年来加速显现。
从全球化到逆全球化,从连锁卡特尔到本地社区经济,人类社会正在反复演练同一模式——当集中带来的效率红利被脆弱性、依赖性和控制权丧失所抵消时,分布式方案就会获得新的生命力。从云端大模型到本地模型,相同的趋势有着深远的影响。全球化、连锁卡特尔与云端大模型代表高度集中、规模经济、标准化与网络效应;逆全球化、本地社区经济与本地模型则强调分散、本地适配、控制权与抗脆弱性。
单人创业
可本地部署的大模型越来越强大,单位算力成本持续下降,分散、本地、主权、韧性、无遥测的本地LLM将使个人单干成为创业的默认模式,这是模式类比中最有力的部分——去中心化工具直接降低组织复杂度,加速个体生产力跃升。
- 过去创业常需要组建团队来分摊技术、运维、资金门槛。现在强本地LLM让一个人就能完成过去需要团队的工作,包括软件开发的项目经理/设计师/工程师、公司经营层面的市场销售/产品研发/交付和运营等。
- 类似于本地社区经济让小作坊、个体经营者重新有竞争力。工具足够强大后,协调成本反而成为负担。曾担任哈佛商学院工商管理副教授的Noam Wasserman发现,65%的高潜力初创公司倒闭的原因是人与人之间的冲突,而不是产品或市场问题。结果是更多超级个体或极小团队成为常态,大公司则更多转向平台或生态角色。
传统企业中,产品开发和销售都需要投入大量时间精力,一个人根本无法完成所有工作。有了人工智能,开发出有用的产品并将其推向市场所需的人工时间大幅减少,创业所需的时间和金钱比以往任何时候都少。因此,在自动化之后,个人创业将成为创办初创企业的默认方式。
与你一起追随热点,直接分享人工智能本地化。由于这波人工智能热潮已经持续四年(ChatGPT于2022年11月30日发布),这里就不再面面俱到地科普,并且力求避免过于技术化。
本地LLM
LLM(大语言模型)是指基于深度学习构建的人工智能模型。在现代人工智能应用中,LLM 具有不可替代的核心底座价值。以下几款开源(或开放权重)大语言模型最为流行,大多有适用于本地部署的尺寸:
- Meta Llama 系列
- DeepSeek 系列
- Qwen 系列
- Mistral 系列,Gemma 系列,GLM 系列
本地LLM部署工具
这类工具加载本地模型,并将其功能以本地HTTP Web API的形式暴露出来,供其他应用程序调用。没有统一名称,多认为包括以下技术分层:
- 推理引擎:llama.cpp等
- 运行时:Ollama等
- 桌面应用:LM Studio等
- LLM服务器:vLLM等。
普通用户不用纠结名称,各开发商和社区都会混用(我也一样,习惯使用推理引擎、运行时或者LLM服务器)。虽然Ollama几乎是默认首选,但我建议尝鲜用户可以从KoboldCpp开始。
KoboldCpp 是基于 llama.cpp 的单文件桌面应用,带 Web UI,支持文本生成、简单图像等,适合角色扮演 / 创意写作。
- 只需一个可执行文件,无需安装,极度轻量。
- 和 Ollama 共享同一个 GGUF 模型文件。
- 基于llama.cpp,捆绑 KoboldAI Lite WebUI。
- 擅长编写故事、进行角色扮演。
- 支持图像、视频、语音和音乐生成功能。
以下是两篇本地部署开源大模型及开展应用的文章:
为本地AI构建的计算机
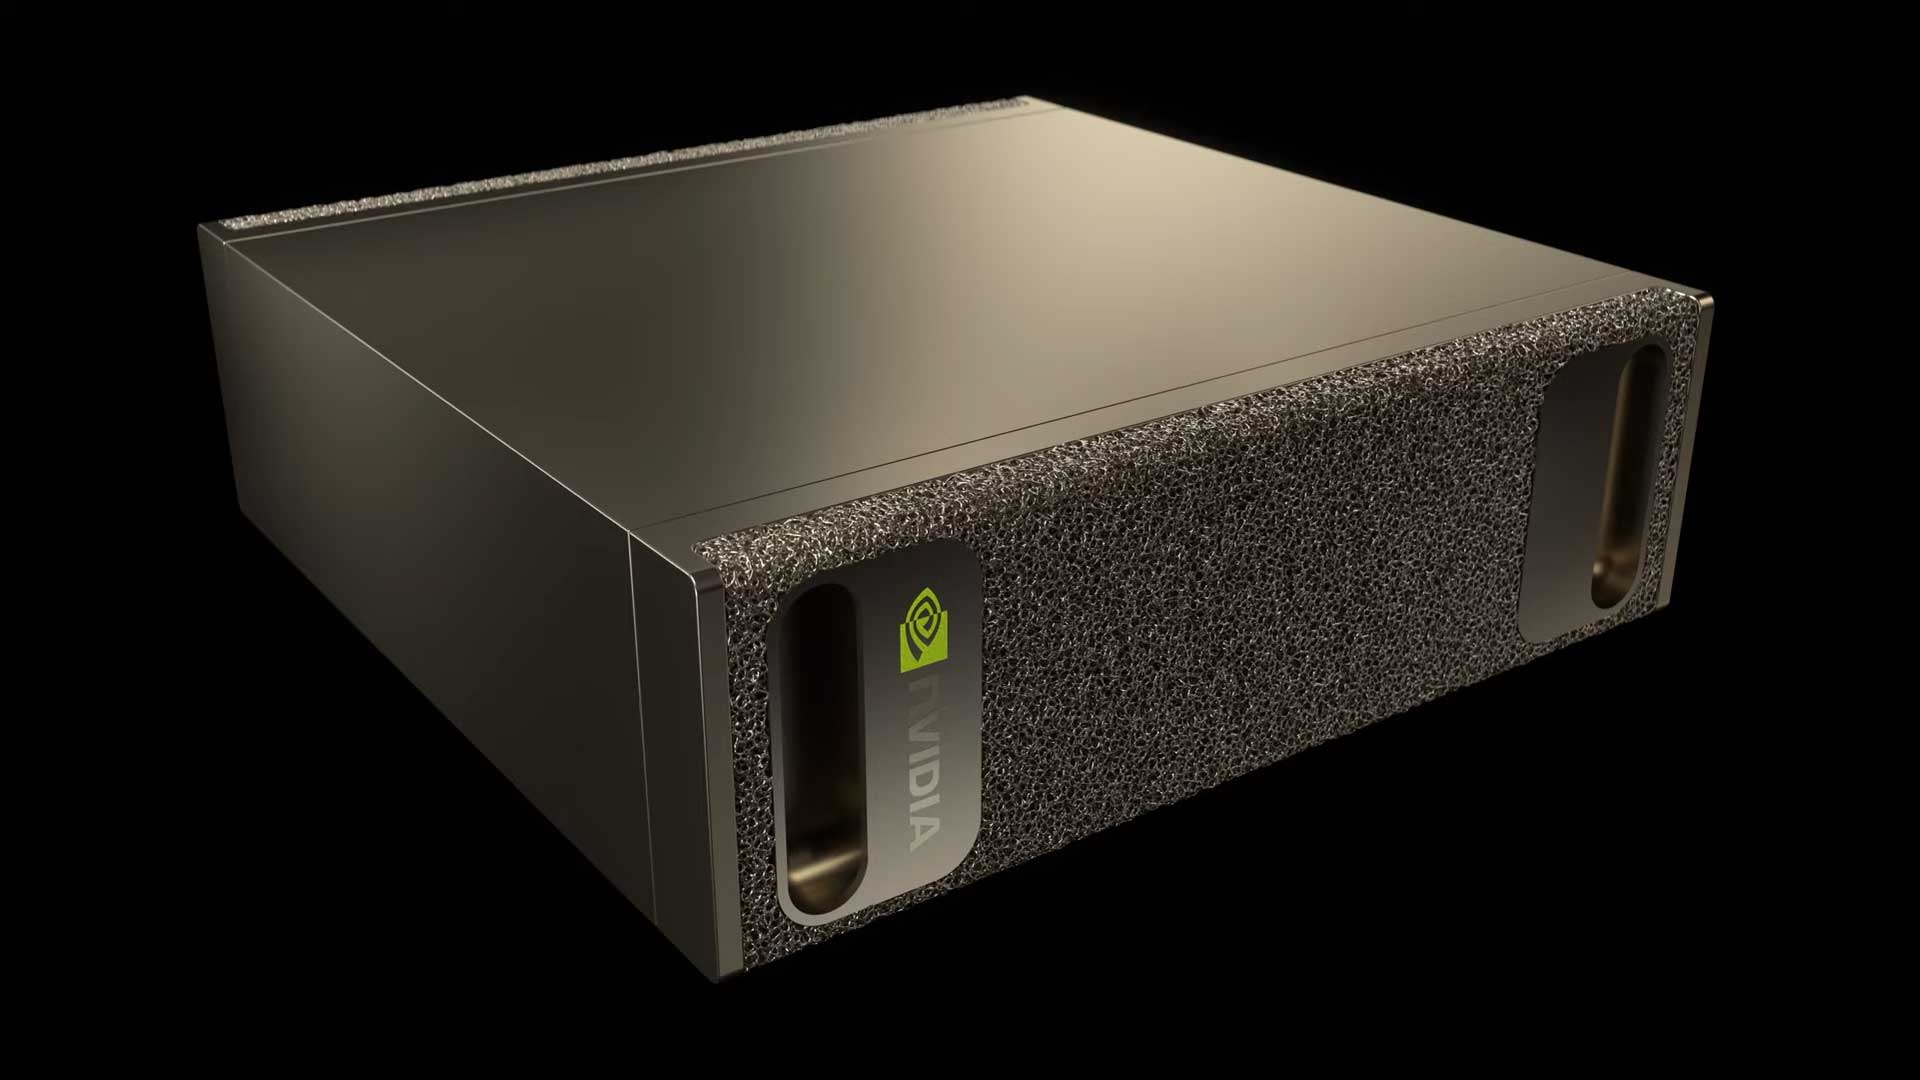
用户逐渐认可了本地模型的经济性和安全性,将其作为云的替代方案或补充方案。苹果、微软和英伟达等公司推出的专用计算机旨在凭借能够在设备端运行更大规模、更强大的开源模型的机器,分得一杯羹。
为本地人工智能而构建的计算机满足那些既希望在本地计算机上构建人工智能应用,又希望设备易于使用的用户。总体而言,苹果的CPU性能更佳,但英伟达的GPU性能更优。苹果和英伟达联合推出的统一内存架构,也解决了内存传输瓶颈。
大模型落地消费级硬件
但是为本地人工智能构建的计算机通常价格高。Strata 继续从软件角度专注大模型落地消费级硬件这一痛点。
Strata,又一个本地推理引擎
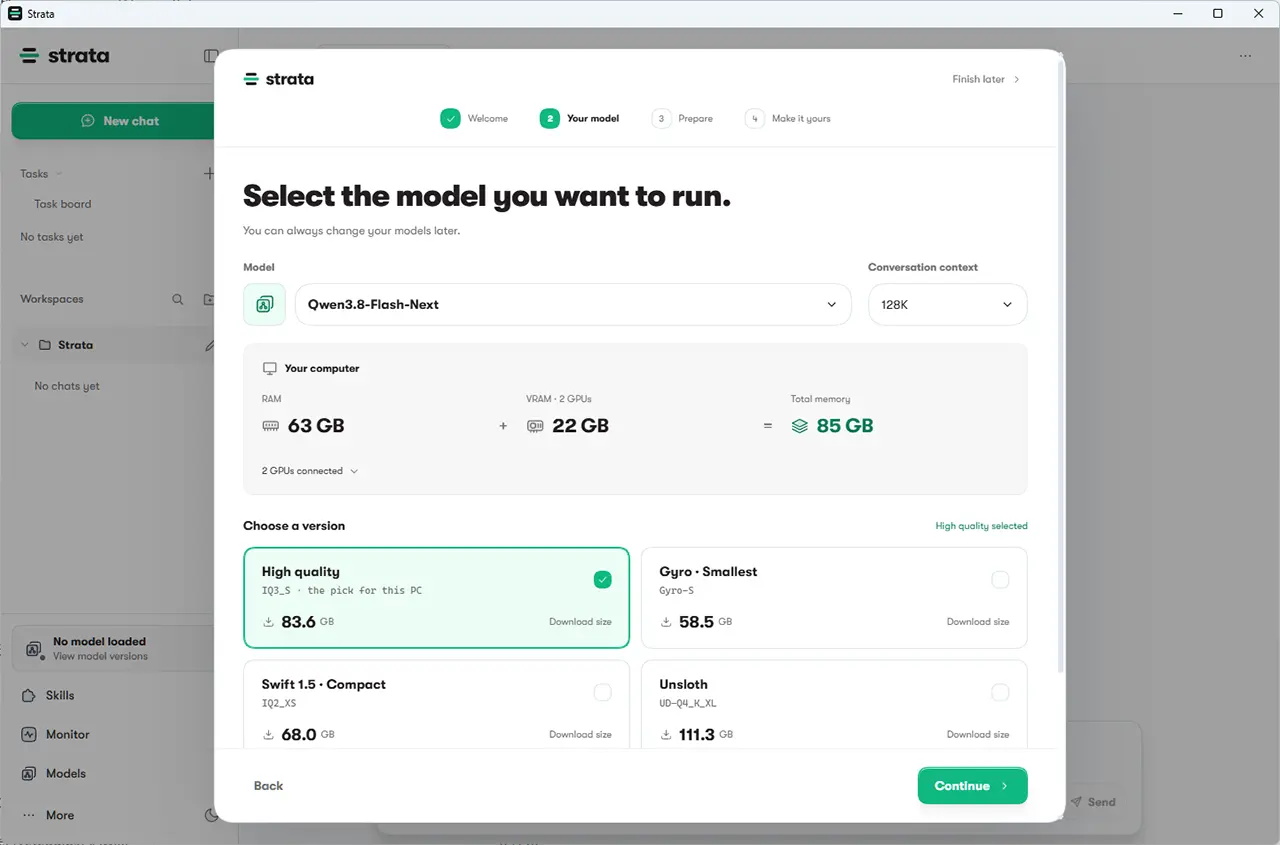
Strata 是一个专门为消费级硬件运行超大 MoE 模型而设计的轻量级推理引擎,支持在本地游戏电脑上运行 Qwen3.8-Flash-Next(以及另一款更小的Qwen3.6-35B-A3B),适配NVIDIA、AMD、Intel主流显卡和Windows、Linux、Mac系统。
Qwen3.8-Flash-Next 是一个约 125B 参数级别的开放权重多模态 MoE 模型,原本需要服务器级硬件运行。现在,只要内存和显存加起来有 32 GB 就足够启动了。
MoE(混合专家)模型是一种人工智能模型架构技术,每次只激活部分专家权重,计算需求极低。在现代推理引擎的内存管理策略支持下,系统会将庞大的模型权重主要存储在容量大且成本低廉的系统 RAM(甚至 NVMe SSD)中,只将当前需要的少数专家权重从 RAM 动态加载到 VRAM 中,再加上量化技术(压缩)的强力辅助,“大 RAM + 小 VRAM”策略极大地降低了运行超大模型的硬件门槛。所以Qwen3.8-Flash-Next发布后,社区热衷推动 128 GB 内存(+24 GB显存)、统一内存、以及“真正重要的是显存+内存”理念。
在消费级电脑上运行 4-bit 量化的 Qwen3.8-Flash-Next,128GB RAM + 24GB VRAM是获得可用体验的甜点。Strata不仅采用深度优化的内存管理,更激进地推荐使用 IQ3_S(甚至 IQ2_XS)的极低比特量化格式。
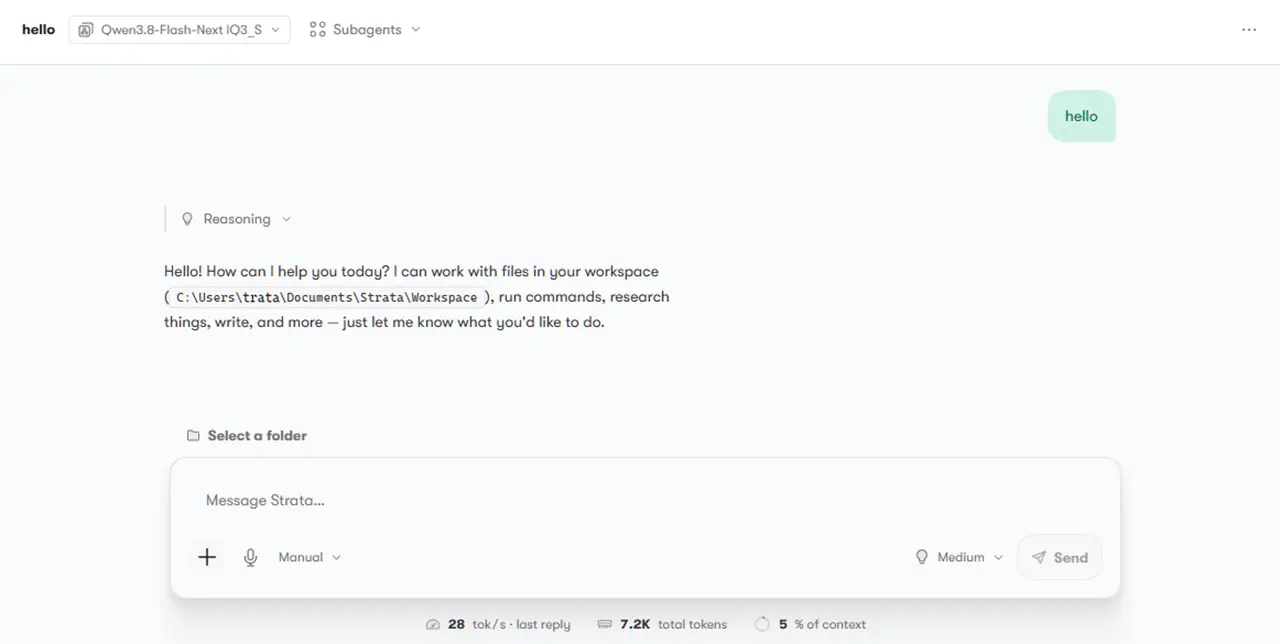
帮您测试一下,64GB RAM + 22GB VRAM,在Ollama中勉强支持到qwen3.8:27b,但在Strata中自动优选到高质量的Qwen3.8-Flash-Next IQ3_S。
如果您的主要用途是长文本分析(如读取整本书或长代码库),仍建议128GB RAM + 24GB VRAM。这样,您可以退回到 Q4_K_M 量化,在获得更高模型精度的同时,拥有充裕的内存来容纳庞大的 KV Cache。这不是云端的消亡,就像全球化没有消失,但逆全球化让供应链更有韧性、本地经济重新获得空间一样。对创业者而言,本地LLM正在把AI从需要资本和团队才能玩的大型游戏变成个人即可上手的基础设施。真正的赢家将是那些能同时掌握本地主权能力,又能在需要时灵活调用云端规模优势的人。